Nieuw: doeltreffende SEO- en GEO-adviezen per pagina
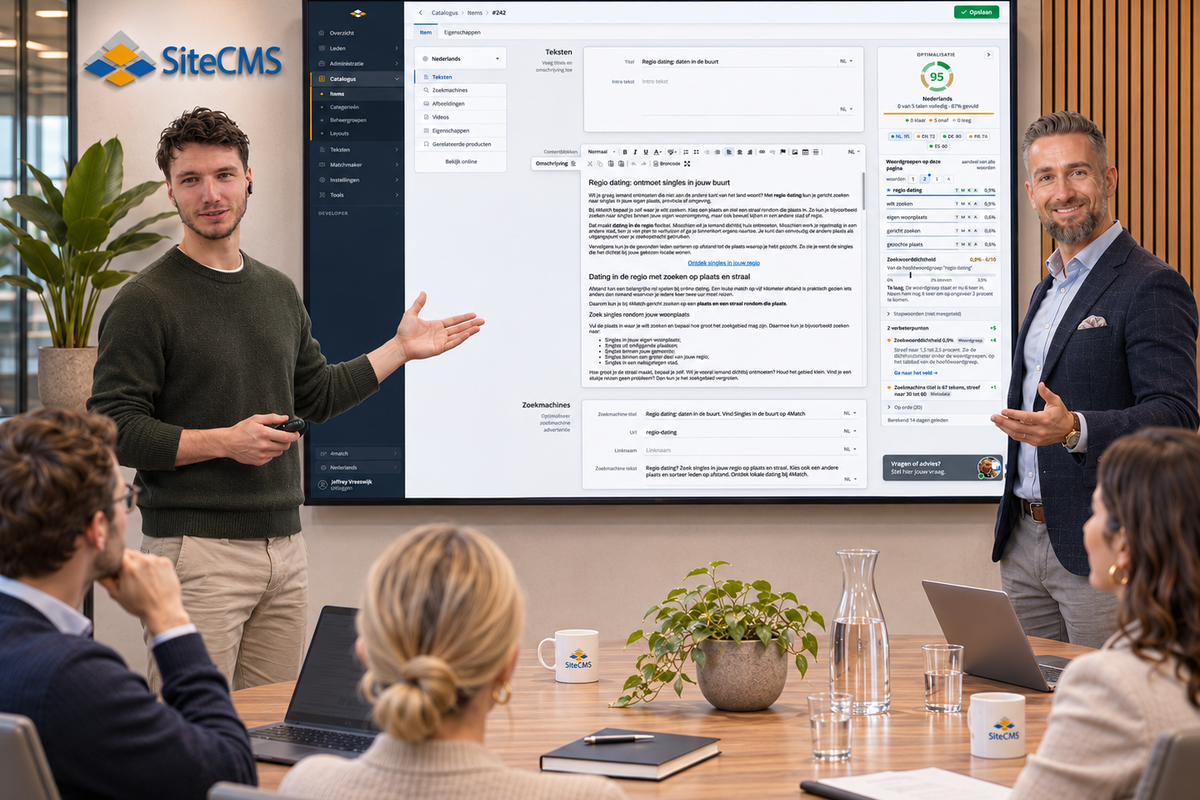
Je ziet nu bij elke pagina in het SiteCMS beheersysteem wat er aan je content te verbeteren valt. Concreet, per taal, en zonder dat je er iets voor hoeft aan te zetten.
Deze update is er voor iedereen die content beheert en wil dat die content ook gevonden wordt. Niet alleen door Google, maar ook door AI-zoeksystemen als ChatGPT en Perplexity, die steeds vaker bepalen wat mensen van je website te zien krijgen. In dit bericht lees je wat er precies gemeten wordt, waarom we bepaalde keuzes hebben gemaakt, en wat het ons op onze eigen site opleverde.
Waar we vandaan kwamen
Eerder gaven we je al een optimalisatiescore per pagina in het overzicht. Daarmee zie je in twee seconden wáár het werk ligt. Alleen: daarna moest je nog steeds zelf uitzoeken wát er dan schort aan die 62.
Sinds een paar weken staat dat er gewoon bij. Naast elke pagina in het SiteCMS beheersysteem zit een paneel dat je vertelt waar de score vandaan komt. En omdat we zelf een hekel hebben aan tools die een cijfer geven zonder uitleg, leggen we hieronder precies uit wat eronder zit.
Wat staat er nu naast je pagina?
Een paneel met vier dingen. Bovenaan de score van de taal die je op dat moment bekijkt, met daaronder alle talen op een rijtje zodat je kan zien hoe het Duits of het Frans ervoor staat zonder je formulier om te zetten.
Daaronder de woordgroepen die je pagina feitelijk gebruikt, met hun aandeel. Daaronder een meter voor je zoekwoorddichtheid. En onderaan een lijstje verbeterpunten, gesorteerd op wat de meeste punten oplevert.
Klik op een verbeterpunt en je springt naar het veld waar het over gaat, dat vervolgens even oplicht. Want een rapport dat je zelf nog moet vertalen naar werk is geen rapport, dat is huiswerk.
Het paneel kan dicht, met een pijltje. Dan blijft er een smal balkje over met je score en het aantal openstaande punten. Staat het dicht, dan rekent er ook niets: wie even snel een prijs aanpast, hoeft geen analyse.
Twee dingen in één rondje
Dat rondje bovenin meet twee dingen die niets met elkaar te maken hebben.
De vulling zegt: is de content er überhaupt, in alle talen? Het systeem kijkt naar de rijkste taal van die pagina en gebruikt die als norm. Wat je in het Nederlands hebt ingevuld, geldt als maat voor het Duits. Gebruik je maar twee van de zes contentblokken? Prima, dan rekenen we je ook niet af op de vier die je niet nodig had.
Een vertaling telt als volledig vanaf 60 procent van de tekenlengte van de referentietaal. Duits is nu eenmaal langer dan Nederlands, Engels korter. Dat mag geen verschil in score opleveren.
Het getal zegt: en is die content ook ergens goed voor? Nul tot honderd, rood onder de 50, groen vanaf 75.
Waar dat cijfer vandaan komt
Vier onderdelen, samen honderd punten. Heeft je pagina geen afbeeldingen, dan valt dat onderdeel weg en rekenen we over tachtig. Een tekstpagina wordt niet gestraft voor plaatjes die er niet horen te zijn.
| Onderdeel | Punten | Wat we meten |
|---|---|---|
| Titel en metadata | 22 | Titel aanwezig, 20 tot 70 tekens. Zoekmachine titel 30 tot 60 tekens. Zoekmachine tekst 120 tot 160 tekens. Leesbare url. |
| Tekstomvang en structuur | 18 | Woordaantal over alle blokken samen, minstens één kop, alinea’s onder de 80 woorden. |
| Woordgroep en dichtheid | 40 | Het zwaarste onderdeel. Zie hieronder. |
| Afbeeldingen | 20 | Alt-teksten gevuld en onderling verschillend, beschrijvende bestandsnamen, title gevuld. |
Die woordaantalcurve is met opzet laf afgesteld: vanaf ongeveer 250 woorden heb je alle punten binnen en krijg je voor meer niets extra’s. We hebben zelf pagina’s van drie regels die prima bovenaan staan. Een model dat lengte beloont, zou die ten onrechte afkeuren.
En ja, IMG_4471.jpg telt als niet-beschrijvende bestandsnaam. Net als iets dat alleen uit cijfers bestaat, of uit een hash waar je hoofdpijn van krijgt.
Het belangrijkste onderdeel: waar gaat je pagina eigenlijk over?
Veertig van de honderd punten gaan hiernaartoe. Reden: Google en AI-zoeksystemen moeten uit je tekst kunnen afleiden waar je pagina over gaat. Dat lukt alleen als er een herkenbare woordgroep in zit.
Je hoeft geen zoekwoord in te vullen
Er is geen invulveld voor een focuszoekwoord. Expres niet. Het systeem leidt de woordgroep af uit de pagina zelf, zodat het ook werkt op de honderden bestaande pagina’s waar nooit iemand iets heeft ingevuld.
We tellen woordgroepen van één tot vier woorden, met de stopwoorden van die taal eruit gefilterd. Een groep telt pas mee als hij zich herhaalt: minstens vier keer bij één woord, drie keer bij twee woorden, twee keer bij drie of vier. Zonder die ondergrens vult de lijst zich met willekeurige stukjes zin, en daar heb je niets aan.
Wat in je titel staat weegt vijf keer zo zwaar als iets in de lopende tekst. In de zoekmachine titel vier keer, in koppen drie keer. In de praktijk bepaal jij dus met je koppen waar de pagina over gaat. Precies zoals het hoort.
In het paneel staan de woordgroepen op tabbladen per lengte: één woord, twee woorden, drie en vier. Dat moest wel, want groepen van verschillende lengte zijn niet eerlijk met elkaar te vergelijken. Een stipje op het tabblad laat zien waar je hoofdwoordgroep zit en waar iets de grens overgaat, ook als je ergens anders kijkt.
Zoekwoorddichtheid? Die was toch dood?
Klopt. Als ranking-factor is zoekwoorddichtheid al twintig jaar dood verklaard, en terecht. Toch zit hij er weer in. Even uitleggen waarom.
AI-zoeksystemen halen stukken tekst op en moeten daaruit afleiden waar een pagina over gaat. Een tekst die nergens consequent over gaat, wordt ook nergens voor opgehaald. Niet omdat een percentage magisch is, maar omdat consequent zijn nu eenmaal helpt.
We rekenen met tekstbeslag: voorkomens × woorden in de groep, gedeeld door het totaal. Een tweewoordgroep die vijf keer voorkomt in 487 woorden staat dus op 2,1 procent.
| Dichtheid | Punten |
|---|---|
| Onder 0,5% | 0, plus de melding dat je pagina nergens over gaat |
| 0,5 tot 1,5% | Oplopend van 0 naar 10 |
| 1,5 tot 2,5% | 10. Hier wil je zitten |
| 2,5 tot 3,5% | Aflopend van 10 naar 0 |
| Boven 3,5% | 0, en er gaan nog 5 punten af |
Die band is met opzet een procentpunt breed. Geef mensen één exact doelgetal en ze gaan millimeteren. Geef ze een band en ze schrijven gewoon door.
En in plaats van je een percentage voor de voeten te gooien, rekent het paneel het voor je om: “De woordgroep staat er nu 6 keer in. Noem hem nog 8 keer om op ongeveer 2 procent te komen.” Daar kan je wat mee.
De meter loopt mee met het tabblad waar je op staat, en je kan op elke woordgroep klikken om hem daar te zetten. Voor een groep die niet je hoofdwoordgroep is krijg je trouwens geen advies om te groeien. Alleen een waarschuwing als hij te hoog zit. Een tweede woordgroep naar 2 procent duwen maakt je pagina namelijk juist troebel.
Waar je woordgroep staat telt zwaarder dan hoe vaak
De overige dertig punten gaan naar de vraag of die woordgroep ook terugkomt op de plekken die ertoe doen. Acht punten voor je titel, vijf voor minstens één kop (en twee erbij vanaf twee koppen), zes voor de zoekmachine titel, vier voor de zoekmachine tekst, drie voor de eerste honderd woorden en twee voor je secundaire woordgroepen.
In het paneel zie je dat per woordgroep als vier vakjes: titel, metadata, koppen, alt-teksten. Groen is aanwezig. Zo zie je in één blik dat je sterkste woordgroep vijftien keer in de lopende tekst staat en nul keer in je titel. Dat soort dingen.
Wat we er bewust uit hebben gelaten
Minstens zo interessant als wat er wél in zit.
- Geen AI die je pagina leest. Alle checks zijn regelgebaseerd en draaien in milliseconden. Een taalmodel per pagina per taal maakt het duur, traag en onvoorspelbaar. Drie dingen die je niet wilt in het SiteCMS beheersysteem.
- Geen instelbare minimale woordaantallen. Klinkt flexibel, levert in de praktijk vooral verkeerd ingestelde drempels op. Vandaar die vroeg verzadigende curve.
- Stopwoorden tellen niet mee. In normaal Nederlands is “de” altijd 5 à 7 procent van je tekst. Dat zegt niets, en het mag je woordgroepen niet vervuilen.
- Geen straf als twee pagina’s hetzelfde onderwerp hebben. We melden het wel, maar we trekken geen punten af. Dat is een probleem van de site, niet van de pagina, en aftrekken zou beide pagina’s straffen zonder te zeggen welke moet wijken.
- Geen controle op structured data. Die zetten wij buiten het SiteCMS beheersysteem om goed. Controleren wat je zelf al geregeld hebt, is tijdverspilling.
Waarom het vijf minuten duurt
De score wordt niet berekend als je opslaat, maar vijf minuten na je laatste opslag. Sla je opnieuw op, dan schuift dat moment weer vijf minuten door.
Niet omdat het zwaar is. Tokeniseren en alle checks over een paar kilobyte tekst kost twee tot vijf milliseconden per taal. Het is er om je opslagactie snel te houden en om niet bij elke tussentijdse save opnieuw te gaan rekenen.
In de tussentijd zegt het paneel gewoon dat de score verouderd is, met een teller erbij. Anders zit je je af te vragen waarom je wijziging niets doet, en dat is precies het soort frustratie waar we vanaf wilden.
Werkt het? We hebben het op onszelf losgelaten
Getest op onze eigen datingsite, 4match.nl. De afgelopen maanden hebben we daar alle pagina’s langs het paneel gelegd en opgelost wat eruit kwam.
Over 13 augustus tot 10 november 2026 staan er in Google Search Console 3.542 klikken en 88.791 vertoningen. Interessanter dan die totalen is de beweging erin:
| Eerste 30 dagen | Laatste 30 dagen | |
|---|---|---|
| Klikken per dag | 21 | 61 |
| Vertoningen per dag | 614 | 1.492 |
| Gemiddelde positie | 15,0 | 9,8 |
Drie keer zoveel klikken per dag, en van pagina twee naar de onderkant van pagina één. Dat laatste is waar het hem in zit: de pagina’s stonden er al, ze werden alleen niet gevonden.
Het aardige zit in waar die groei vandaan komt. Niet van de eigen merknaam, want daar zoekt vrijwel niemand op. Maar van doelgerichte pagina’s: pagina’s die over één ding gaan en daar ook op geoptimaliseerd zijn.
| Pagina | Klikken | Vertoningen | Gem. positie |
|---|---|---|---|
| Senioren dating | 174 | 11.156 | 10,7 |
| Biseksuele dating | 166 | 1.890 | 6,0 |
| Regio dating | 36 | 639 | 6,0 |
Stuk voor stuk pagina’s met een duidelijk onderwerp, waar het paneel precies kon aanwijzen wat er nog ontbrak: een woordgroep die niet in de titel stond, metadata die te kort was, alt-teksten die niemand had ingevuld. De regionale pagina’s staan nog aan het begin van die weg; daar moet het effect nog komen.
Cijfers uit Google Search Console, 13 augustus tot 10 november 2026, zoektype web.
Eerlijk is eerlijk. Dit is geen gecontroleerd experiment. In dezelfde periode zijn er pagina’s bijgekomen en is er aan de techniek gesleuteld. De stijging is dus niet volledig op het conto van het paneel te schrijven. Wat het wél deed: per pagina laten zien wat er mis was, in plaats van dat je het zelf moest bedenken.
En dan de volgende stap: SiteCMS Intelligence
De adviezen krijg je sowieso. Die staan standaard aan op elke pagina, je hoeft er niets voor in te schakelen. Wat je er vervolgens mee doet, is aan jou.
En daar zit meteen het handwerk. Bij honderden pagina’s in vijf talen is “je weet nu wat er mis is” nog altijd een flinke stapel werk.
In een toekomstige update kan je daarom SiteCMS Intelligence aanzetten. Vanaf dat moment gaat SiteCMS zelf met de adviezen aan de slag:
- Fatsoenlijke bestandsnamen bedenken voor je afbeeldingen, in plaats van
IMG_4471.jpg - De zoekwoorddichtheid bijstellen tot die in de band zit
- Je metadata bepalen: zoekmachine titel en tekst, binnen de juiste lengte
- De HTML-structuur verbeteren, zodat je koppen kloppen en je tekst leesbaar is opgebouwd
Het mooie daarvan is dat het niet eenmalig is. De score wordt na elke wijziging opnieuw berekend, dus zodra er iets verschuift, gebeurt er weer iets. Je website blijft daarmee doorlopend geoptimaliseerd, ook op de pagina’s waar je zelf al een halfjaar niet meer naar hebt gekeken.